Making eDNA FAIR
なぜFAIR eDNAが必要か?
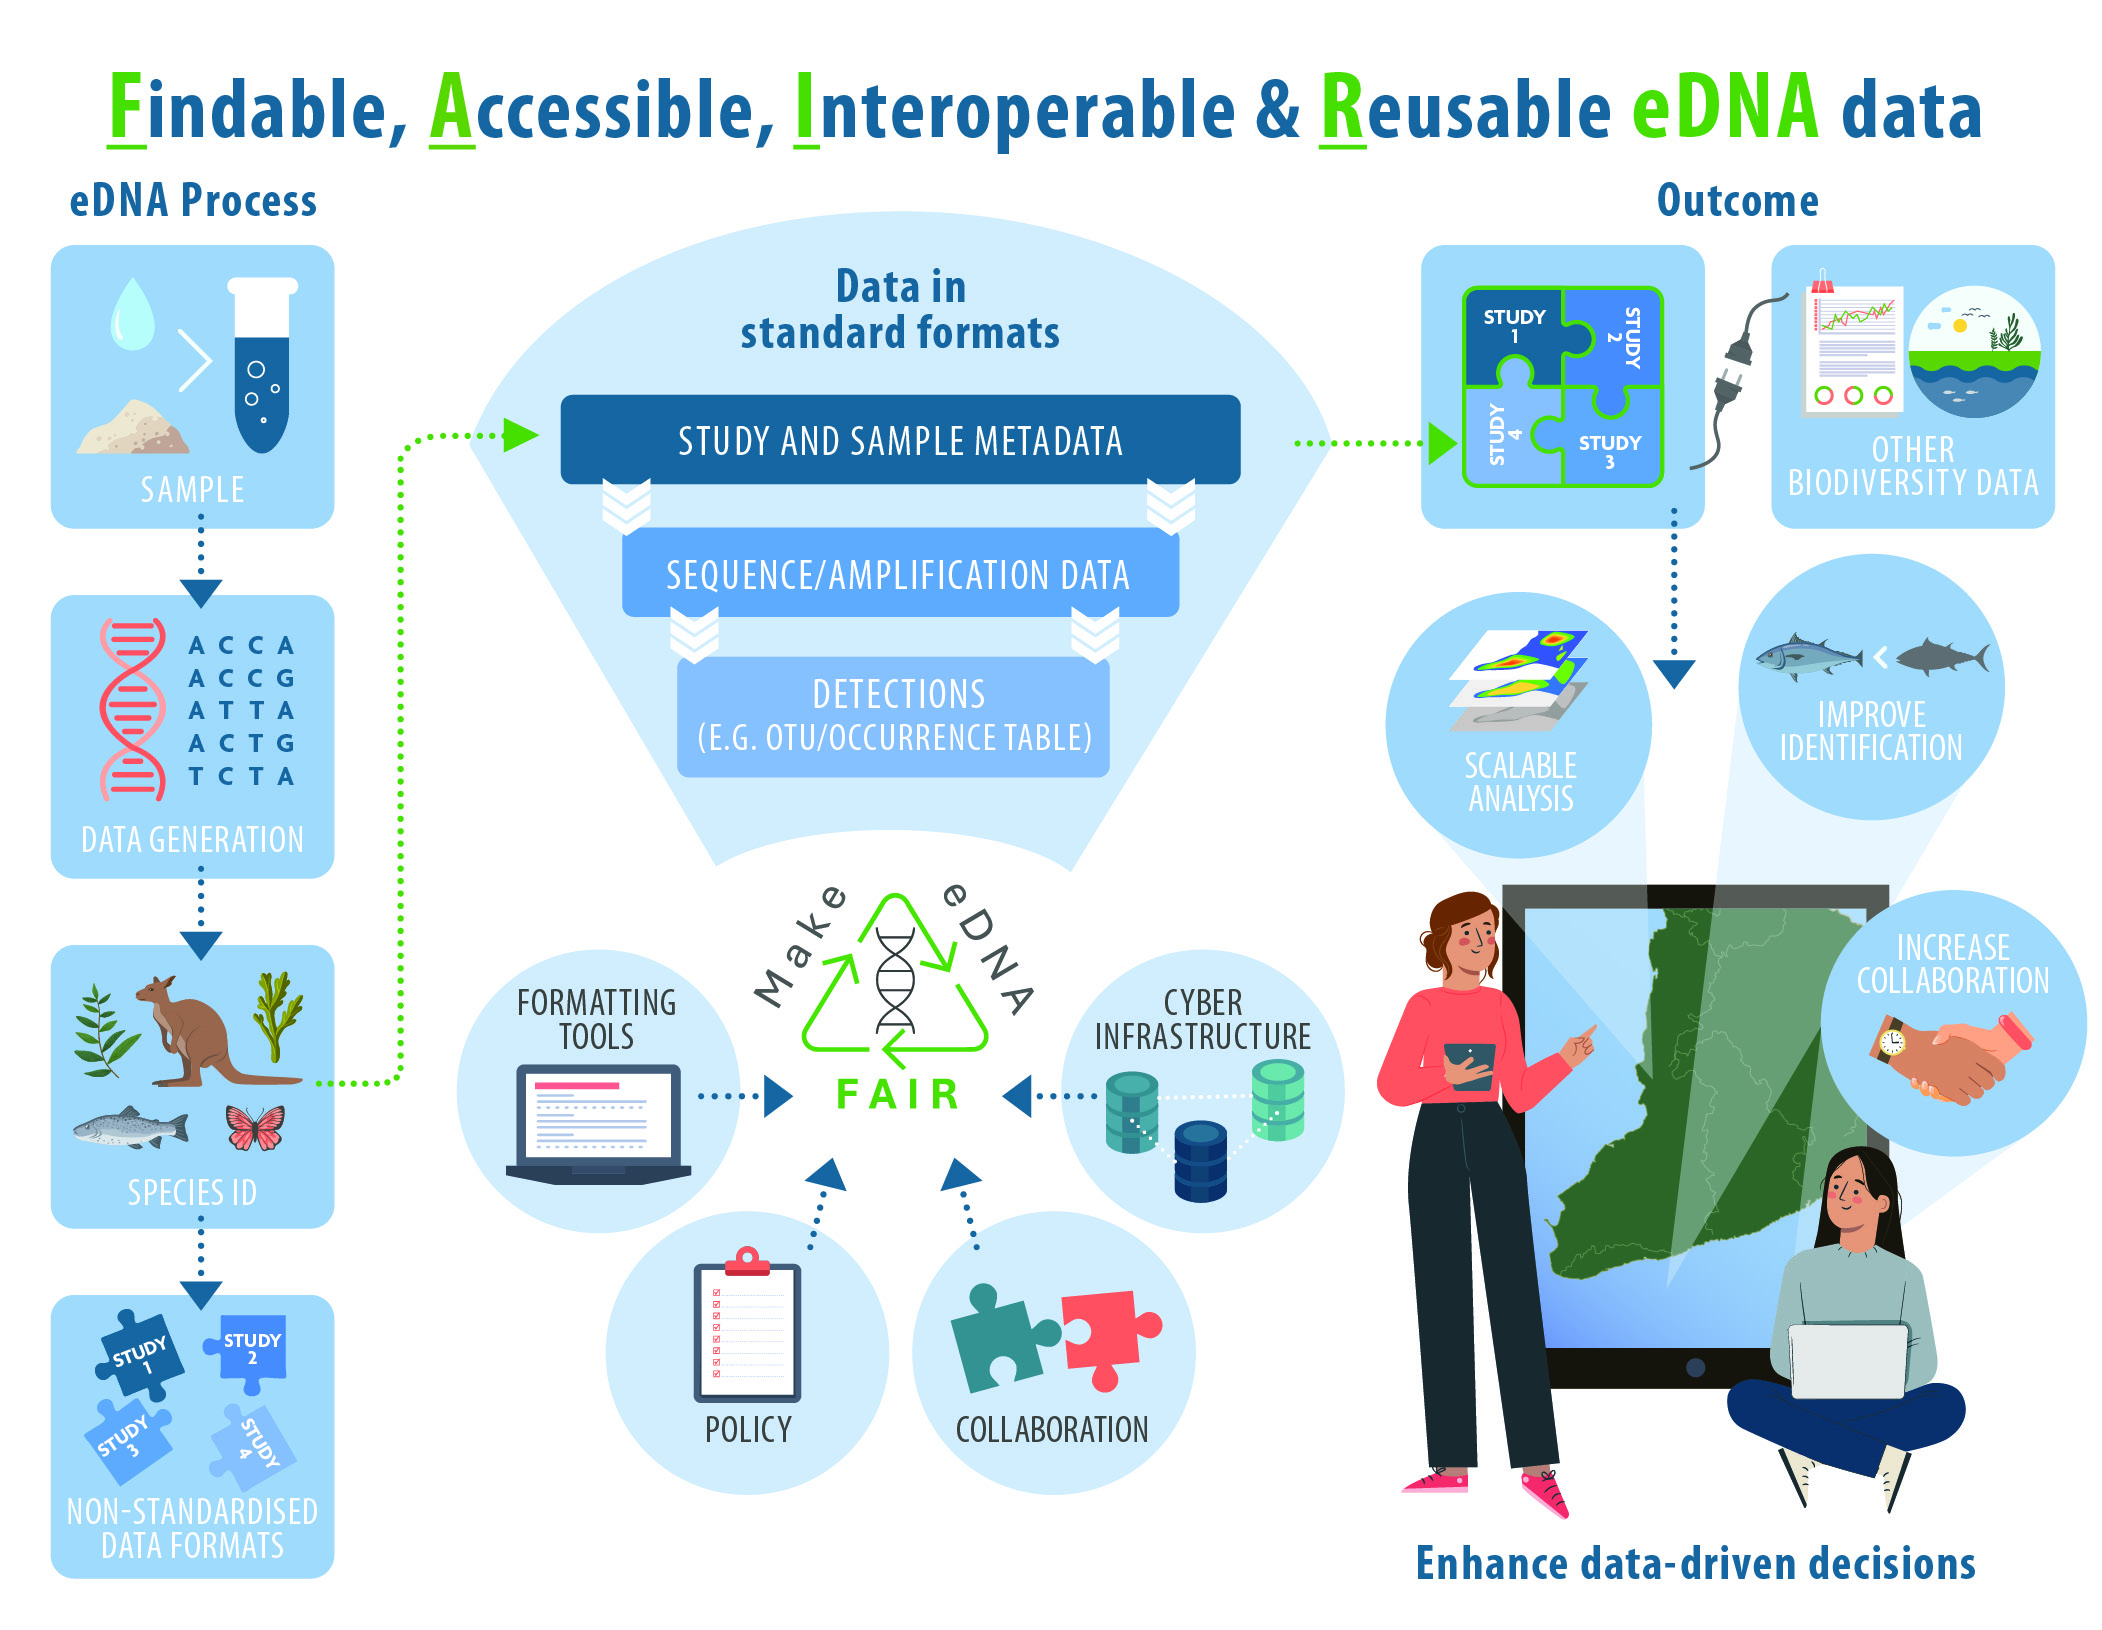
環境DNA(eDNA)を用いた種検出手法の成功は、生物多様性モニタリングや分布マッピングに革命をもたらしました。定量PCRなどのターゲット型eDNA増幅法は種の分布理解を深め、メタバーコーディングに基づく手法はこれまでにない規模と分類学的解像度での生物多様性評価を可能にします。しかし、eDNAデータセットはしばしばリポジトリに散在し、フォーマットが統一されていなかったり、アクセス制限が異なったり、メタデータが不十分であるため、相互運用性や再利用性、全体的な影響力が制限されています。eDNAデータにFAIR(Findable, Accessible, Interoperable, Reusable:検索可能、アクセス可能、相互運用可能、再利用可能)データ実践を採用することは、生物多様性および個々の種のモニタリングを変革し、広域的なデータ駆動型の生物多様性管理を支援します。FAIRの実践はeDNAコミュニティではまだ十分に発展しておらず、その一因として、Darwin Core (DwC) や Minimum Information about any (x) Sequence (MIxS) のような既存語彙をeDNA固有のニーズやワークフローに適応させる際のギャップが挙げられます。
プロジェクトの範囲
eDNAベースの研究に特化して既存のデータおよびメタデータ標準を微調整、最適化、拡張することは、FAIR eDNAを達成するための重要な第一歩です。本プロジェクトでは、既存のデータ標準を統合し、eDNAワークフローに合わせた新しい項目を導入する包括的なFAIR eDNA(FAIRe)メタデータチェックリストを提案します。
メタデータは、生データ(例:メタバーコーディング配列、ターゲット型qPCRアッセイのCt/Cq値)および派生した生物学的観測(例:ASV/OTUテーブル、種の存在/不在)双方に体系的に紐付けられます。フォーマットガイドライン、ツール、テンプレート、サンプルデータセットとともに、FAIR eDNAの実践のための標準化された即利用可能なアプローチを提示します。
これらの取り組みにより、データ提供者の指針となり、FAIRデータ実践に整合したeDNAデータセットを曖昧さなく記述することを容易にすることを目指します。私たちの目標は、既存のデータ標準、インフラ、データベースが自らの目的により適合できるよう、ギャップを埋めるための資源としてFAIReメタデータチェックリストとガイドラインを提供することです。これらのガイドラインは、個々のeDNA研究者や研究室のデータ管理の標準化を改善し、データを外部再利用者だけでなく内部の組織にとってもよりFAIRにする点で役立ちます。