ガイドライン
FAIR eDNA(FAIRe)ガイドライン
このセクションでは、さまざまなデータコンポーネントとフォーマットを概説し、包括的なFAIR eDNA(FAIRe)メタデータチェックリスト (ダウンロードは こちら)およびデータ整形プロセスを案内するスクリプトやツールを提示します。
データフォーマットとコンポーネント
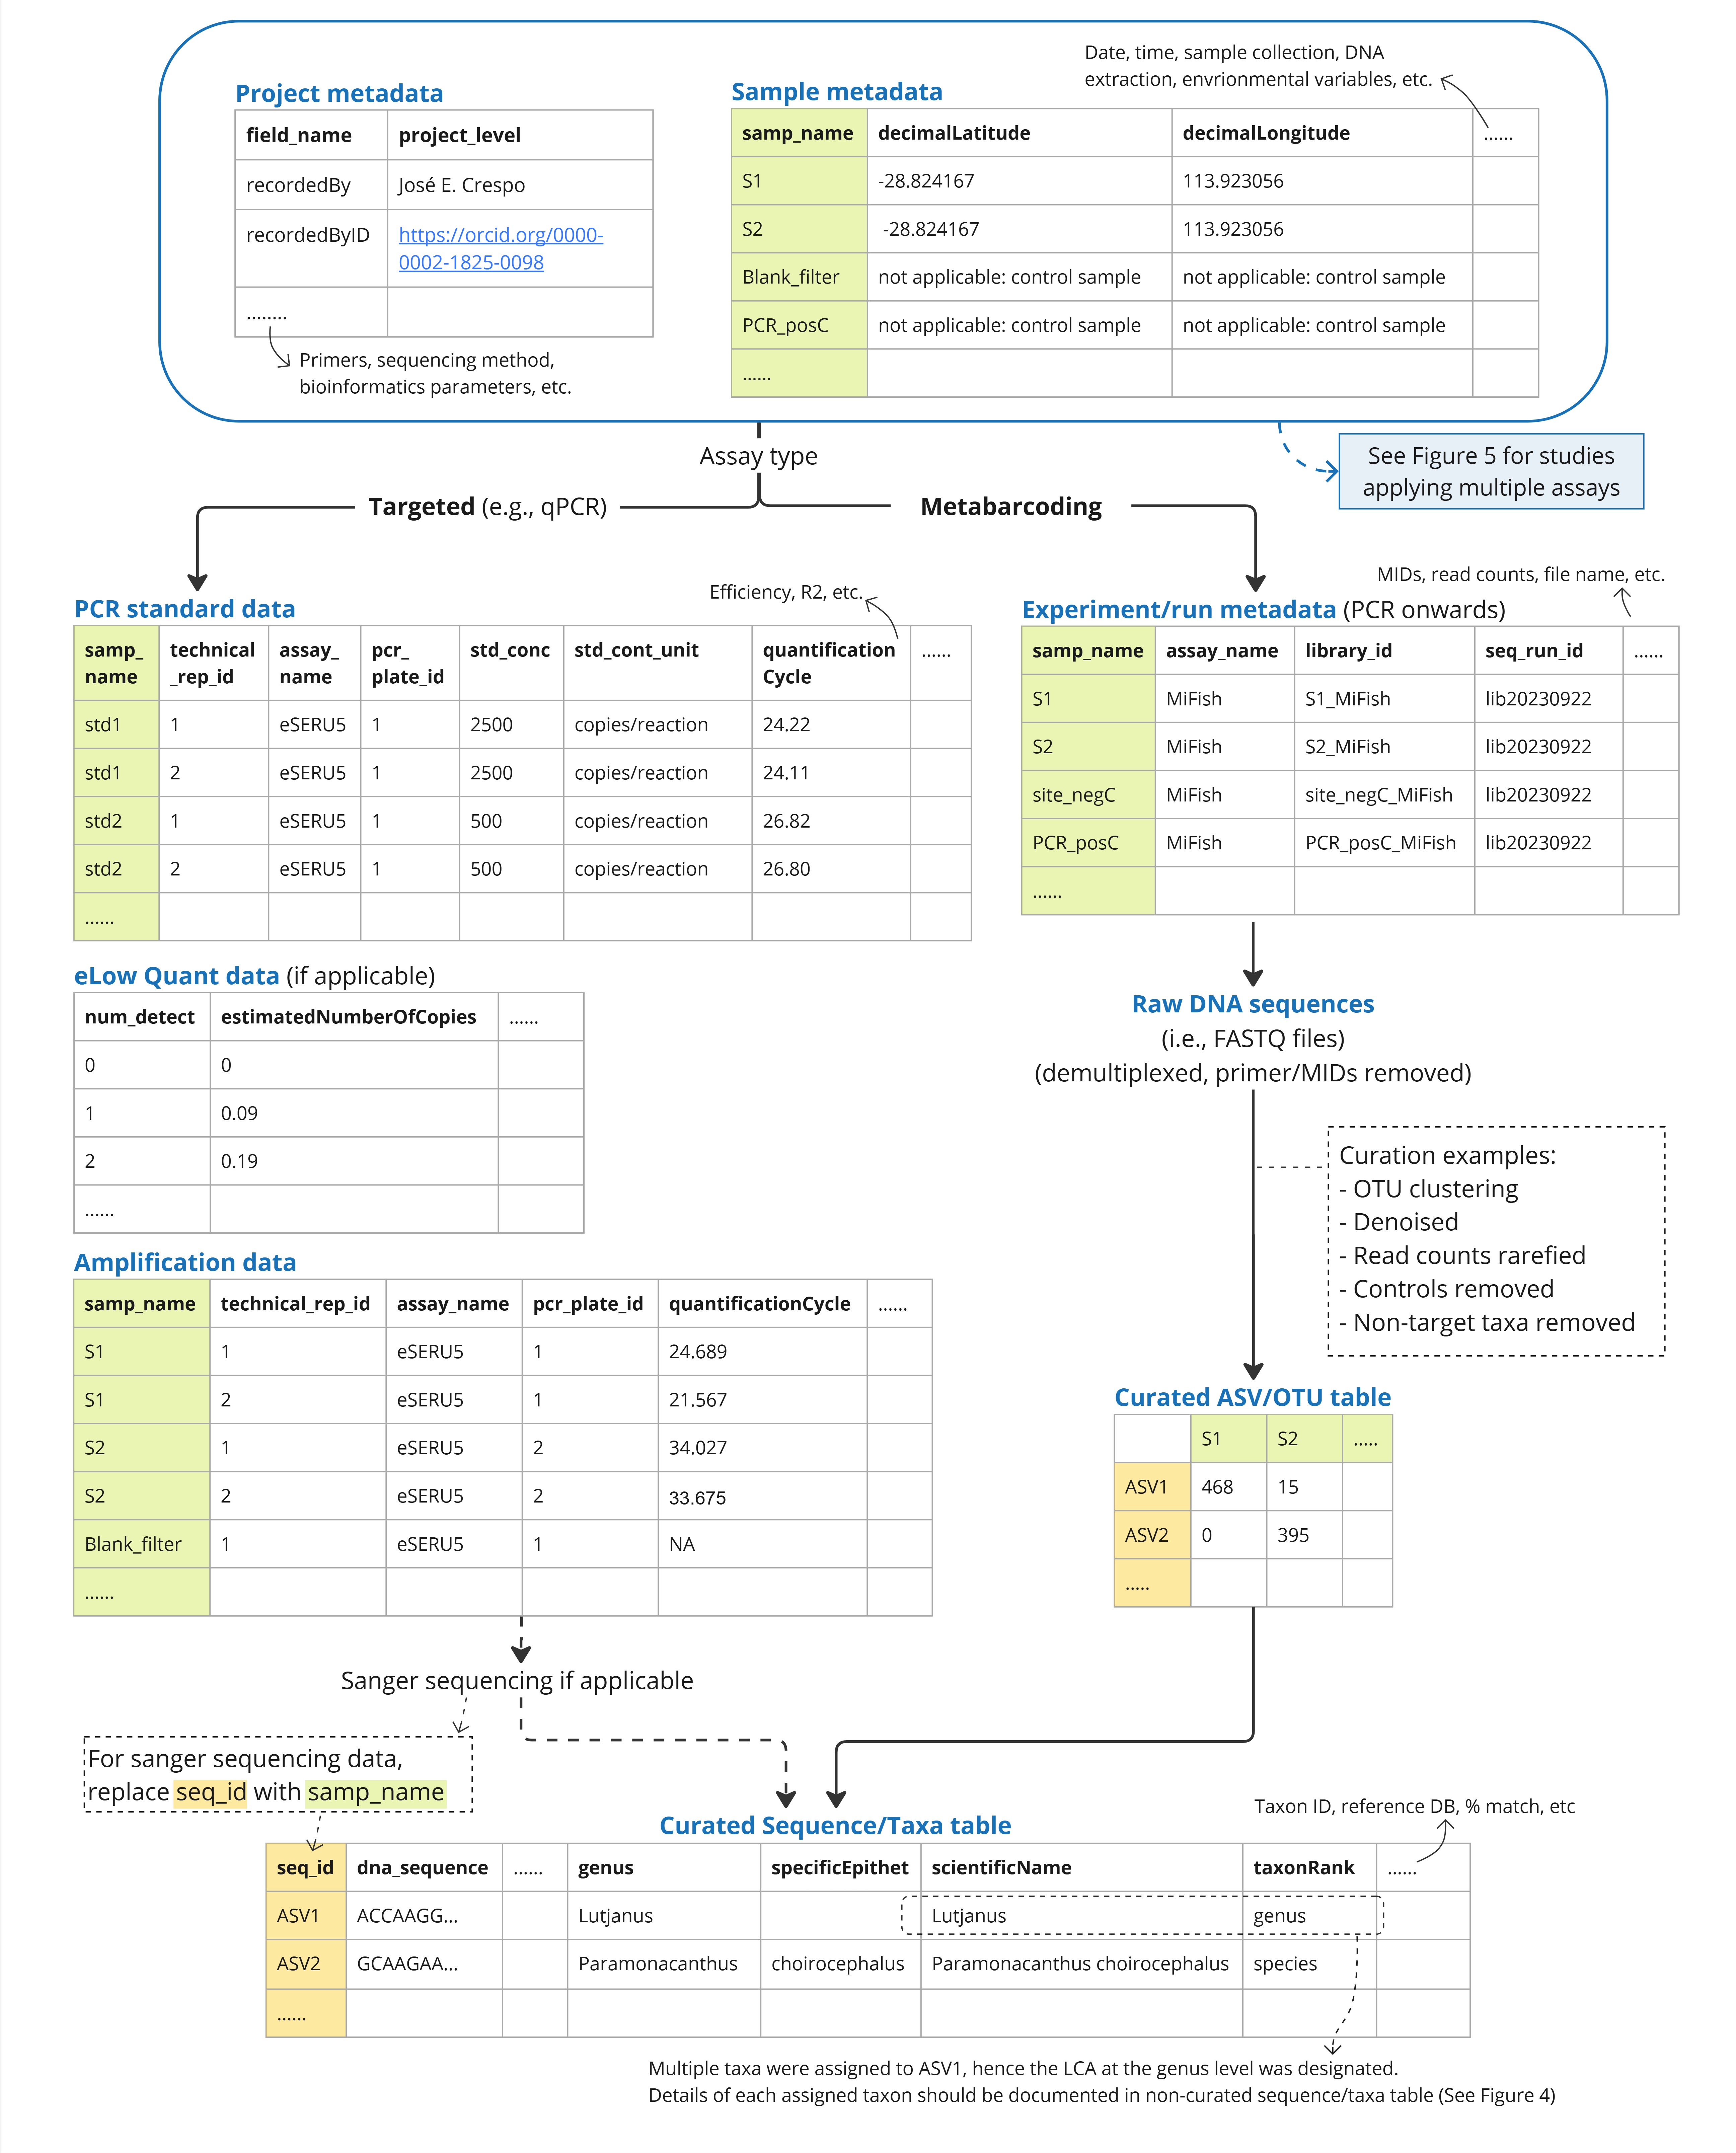
下の図とリストは、関連するeDNAデータコンポーネント、およびそれらの内容と目的を示しています。提案するデータ構造では、DNA配列データ(すなわちFASTQの生データおよび任意で代表配列のFASTA)を除くすべてのデータコンポーネントは、表形式(タブular形式)で整理されます。これらは、スプレッドシートワークブックの個別ワークシート、文字区切り値テキストファイル(タブまたはカンマ)、またはそれらの組み合わせとして保存できます(提供されている各種サンプルデータセット参照)。これにより、データは概念的に別モジュールへ分割され、project_id、sample_name、assay_name のような一意識別子でリンクできるほか、利用者のニーズやデータ整形の好みに対応できます。
-
Project metadata(projectMetadata)
- 内容: プロジェクト全体およびデータセット全体に適用される情報。プロジェクト名、データセットの由来となる参照(例:研究の書誌参照、公開されたデータのDOI)、およびPCR、シーケンシング、バイオインフォマティクス工程を含むワークフローのメタデータを含みます。
- 目的: 全サンプルに共通するプロジェクト情報や手法を記述し、サンプルメタデータに同じ項目を繰り返し記載する必要を避けること。バイオインフォマティクスの品質フィルタリングパラメータや閾値などに関する情報は、データ再利用者がデータ品質が特定の再利用要件を満たすかどうかを評価するのに役立ちます。増幅解析、バイオインフォマティクスワークフロー、品質保証レベルの最小要件は研究や用途により異なるため、これら情報の標準化は特に重要です。
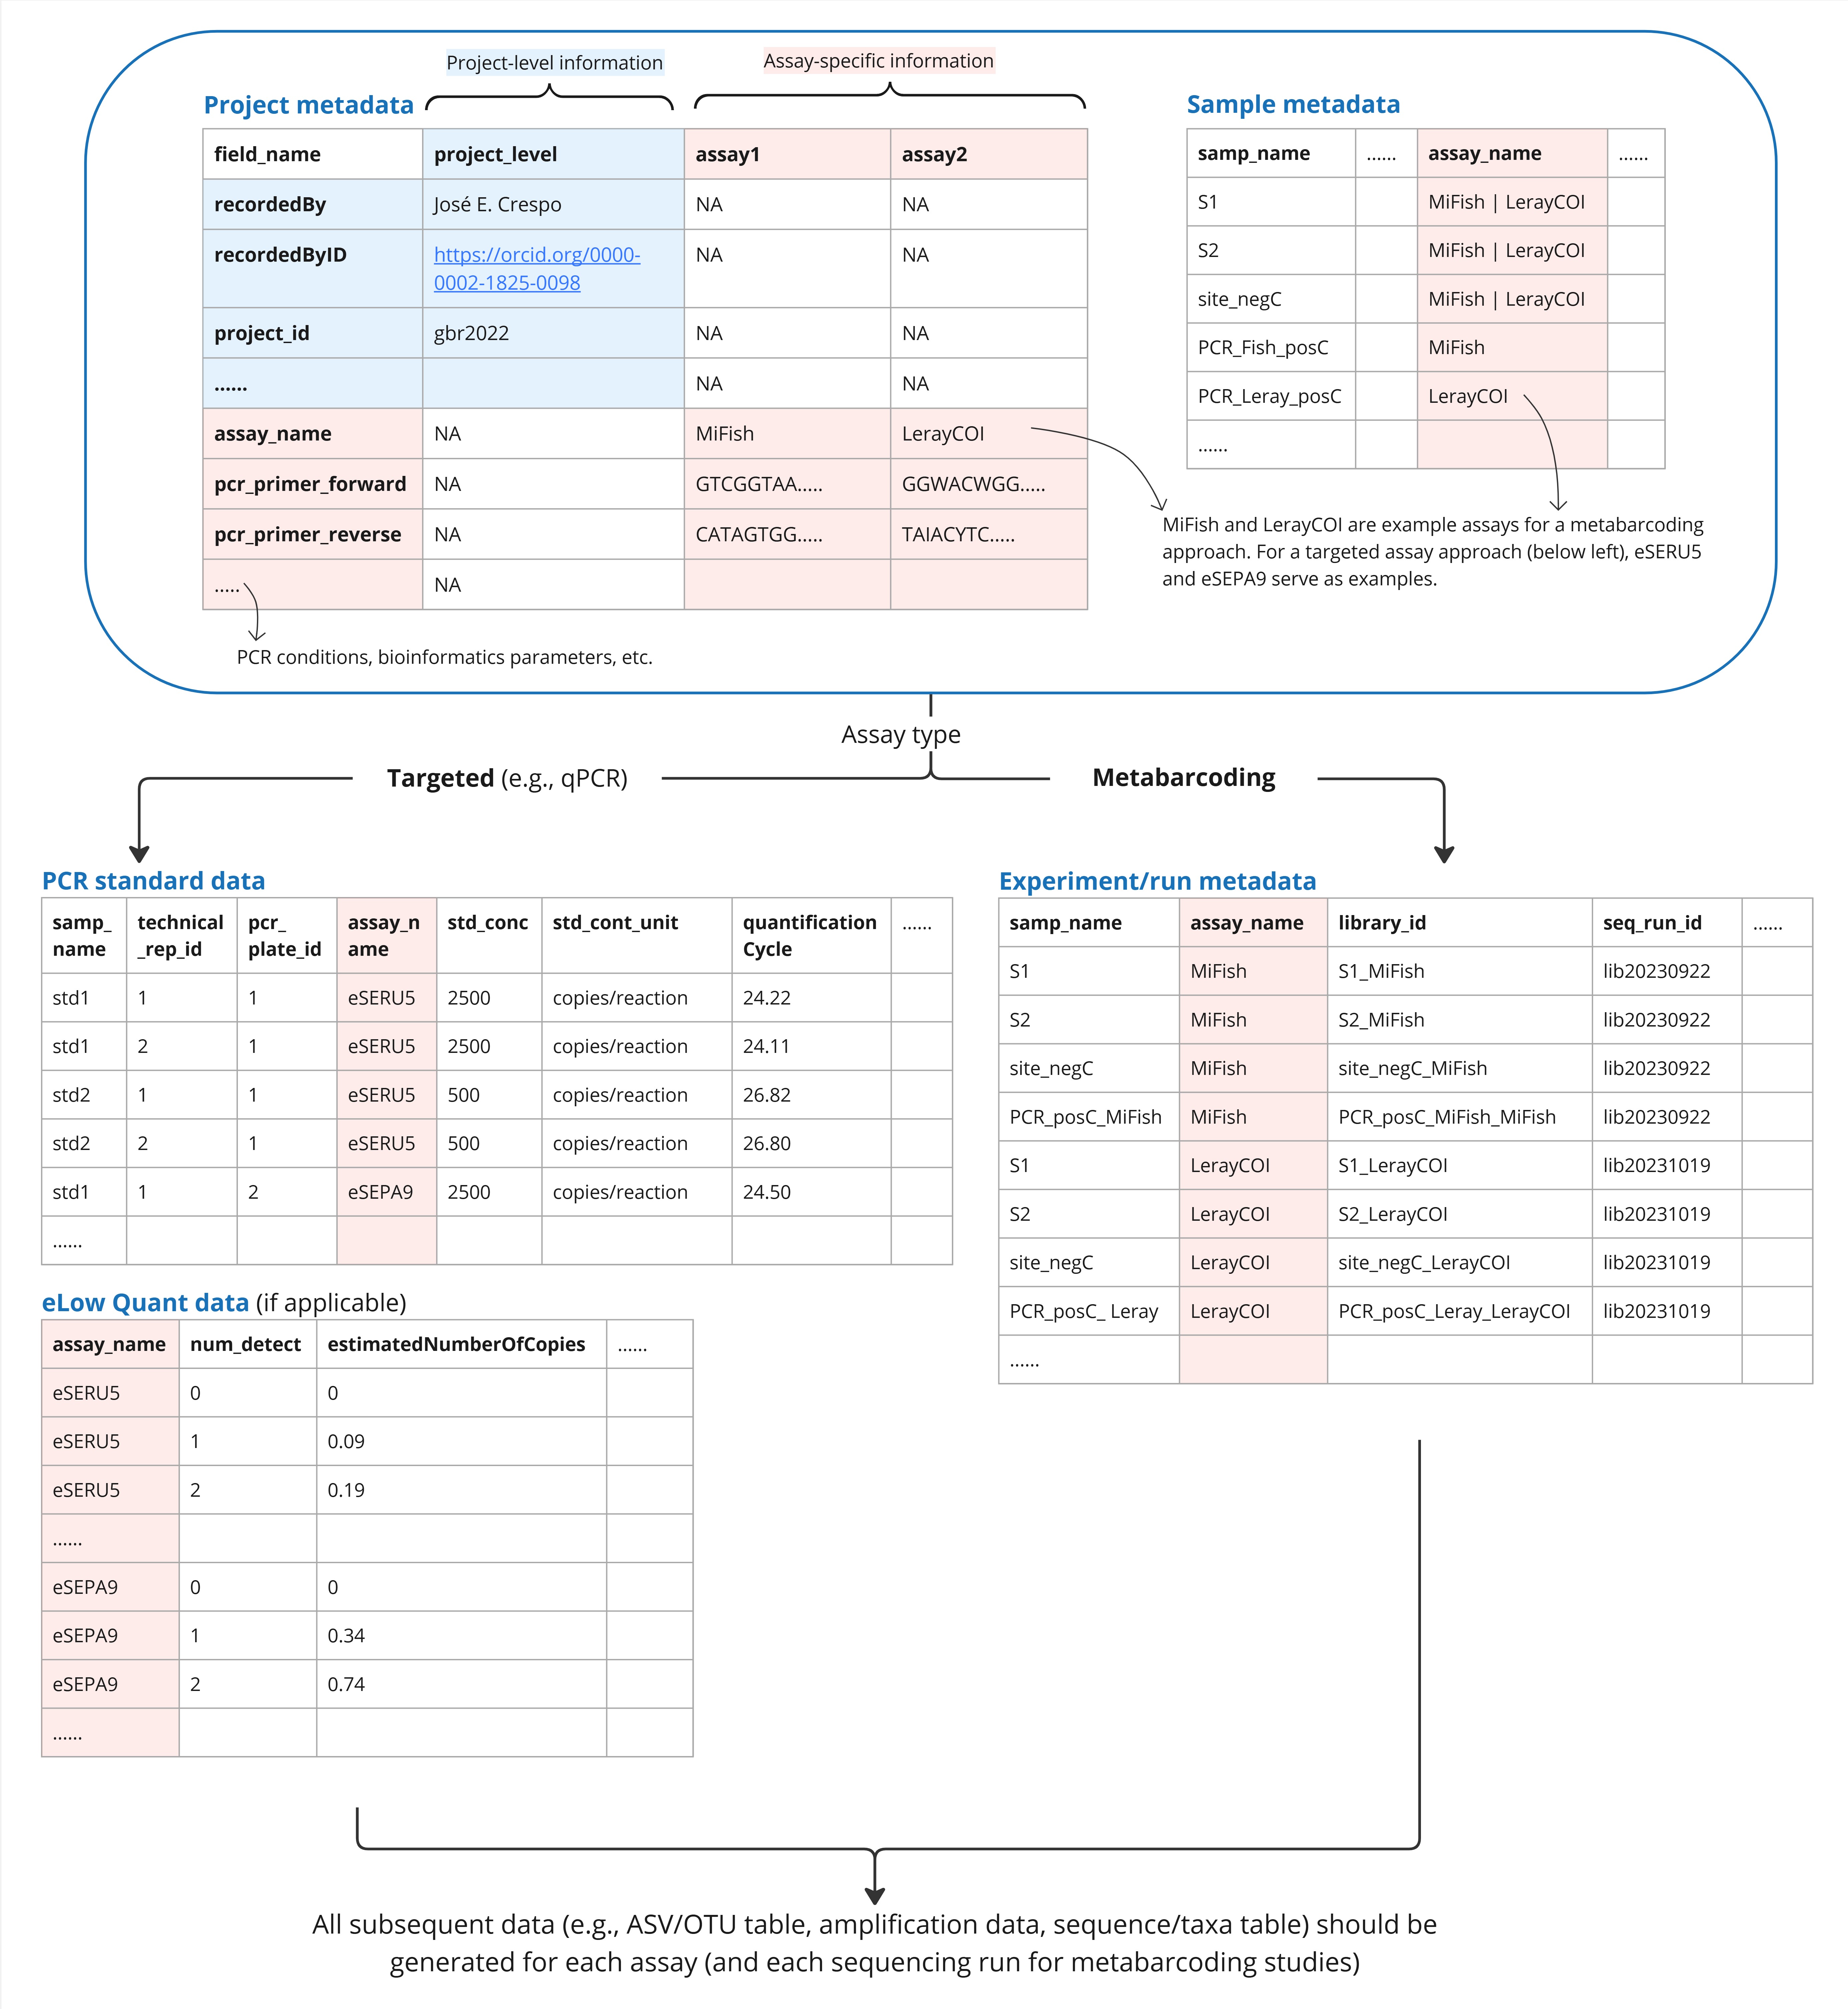
- 注: 1つのプロジェクト内で複数のプライマーセットを使用して複数の分類群を対象とすることがよくあります。この場合、アッセイ固有のワークフローと出力を記録するために図5の形式に従います。
-
Sample metadata(sampleMetadata)
- 内容: 各サンプルに関する情報(プロジェクトレベルで記載できないもの)、採取日、位置情報、手法、環境変数(例:温度、水深)など。
- 目的: 採取からバイオインフォマティクスまでのワークフローに沿ったサンプル固有の情報を記録すること。
-
Experiment/run metadata(experimentRunMetadata)
- 内容: PCR、ライブラリ調整、シーケンシングワークフローに関するサンプル固有の情報。
- 目的: PCR以降の、各サンプルおよびアッセイに特有なワークフローを記録すること。
- 注: 各エントリ(行)は一意のライブラリID(
lib_id)およびマルチプレックス識別子(MIDs)(mid_forward、mid_reverse)を持ちます。
-
PCR standard data(stdData)
- 内容: 初期入力量、Ct/Cq値、標準曲線パラメータ(例:効率、R2)など、PCR標準に関する詳細情報。
- 目的: 再現性を向上させ、データ再利用者が独自の手法で推定コピー数を再生成できるようにすること。PCR標準データと増幅データ内の
assay_nameおよびpcr_plate_idのエントリにより、標準とeDNAサンプルをリンクできます。
-
eLow Quant data(eLowQuantData)
- 内容: 該当する場合、PCR標準に対するeLow Quant二項法の出力(Lesperance et al., 2021参照)。
- 目的: 再現性を向上させ、データ再利用者が独自の方法で推定コピー数を再生成できるようにすること。
-
Targeted assay amplification data(ampData)
- 内容: eDNAサンプルに対して実行された各PCRテクニカルレプリケートの生の増幅データ、標準曲線に基づく推定コピー数(該当する場合)、および各生物学的レプリケート(フィールドサンプル)における標的分類群の検出状況。
- 目的: 各テクニカルレプリケートのCt/Cq値は、上記標準情報と組み合わせることで将来の研究で生の増幅データを濃度や検出状態に再変換することを可能にします。生物学的レプリケートレベルでの検出/非検出記録は、サンプルメタデータと組み合わせて将来の研究での分類群出現記録の迅速な再利用を可能にします。また、他の手法で得られた生物多様性データとの整合性を標準化し、それによって集合的なデータと基礎研究を幅広い利用者に発見可能かつ再利用可能にします。
- 注:
quantificationCycle(Ct/Cq値)には増幅が起きなかったことを示すために「NA」(ゼロではない)を使用してください。ゼロは非常に高いDNA濃度(ターゲットDNAであるかどうか不明)を意味する可能性があり、標準曲線の範囲外で定量不能であると誤解されるおそれがあります。
-
Raw DNA sequences
- 内容: 各サンプルごとにデメルチプレックス(demultiplex)されたFASTQ形式のDNAシーケンス。プライマー、アダプター、MIDは除去済みであること。
- 目的: データ再利用者が独自のアルゴリズムと閾値で品質フィルタリング、デノイジング、分類学的割り当てをやり直すことを可能にするため。異なるまたは改良されたパイプライン/アルゴリズムを用いた再解析を可能にし、研究の再現性を高めます。
-
非キュレーション済みASV/OTUテーブル(otuRaw)(任意)
- 内容: バイオインフォマティクスパイプラインで生成された初期のASV/OTUテーブルで、すべてのASV/OTUの絶対配列リード数(汚染や非ターゲット分類群、割り当て不能ASV/OTUを含む)を全サンプル(コントロール含む)にわたって含みます。この段階で各ASV/OTUには一意の
seq_idが付与されます。 - 目的: すべてのOTU/ASVのリード数に関する客観的情報を伝え、必要に応じてデータ再利用者がデータキュレーション手順を修正または再実行できるようにすること。コントロールサンプルや疑わしい汚染物質、非ターゲット分類群を含めることで、複数研究にわたる共通汚染配列やその発生源の調査、およびそれらを最小化する方法の特定に寄与します。
- 注: ASV/OTUテーブルの列名は
samp_nameまたはlib_idのいずれかとし、experiment/run metadataとASV/OTUテーブルの間に明確なリンクが保たれるようにしてください。 - 注: “raw”と呼ばれるものの、最小長やリード数、エラー率、OTUクラスタリングに基づくフィルタリングのような一定の圧縮、品質フィルタ、キュレーションが既に適用されている場合があります。非キュレーション済みASV/OTUテーブルに対して実行されたデータキュレーションの程度は使用したバイオインフォマティクスパイプラインによって研究間で異なるため、これはproject metadata内の
otu_raw_descriptionで説明する必要があります。
- 内容: バイオインフォマティクスパイプラインで生成された初期のASV/OTUテーブルで、すべてのASV/OTUの絶対配列リード数(汚染や非ターゲット分類群、割り当て不能ASV/OTUを含む)を全サンプル(コントロール含む)にわたって含みます。この段階で各ASV/OTUには一意の
-
キュレーション済みASV/OTUテーブル(otuFinal)
- 内容: デノイジング(カスタムまたはLULUキュレーション)、コントロールサンプルの除去、疑わしい汚染物や非ターゲット分類群の除去など、さまざまなデータキュレーション工程の結果生じたASV/OTUテーブル。理想的には、関連論文で報告された最終的な(例えば生態学的)解析に用いられたテーブルと同一またはほぼ一致するべきです。分類学的割り当てがないASV/OTUも解析に関連があればotuFinalに残してください。
- 目的: 元の(生態学的)解析の再現性と、キュレーションされた/クリーンなデータの一般的な再利用を促進すること。他の種類の生物多様性データとの相互運用性を高め、一般的な生物多様性データベースへの組み込みを促進し、データと基礎研究をより幅広い利用者に発見可能かつ再利用可能にします。
- 注: ASV/OTUテーブルの列名は
samp_nameまたはlib_idのいずれかとし、experiment/run metadataとの明確なリンクを維持してください。 - 注: 研究によっては、同一分類群に割り当てられた複数のASV/OTUを集約してリード数を合算する場合がありますが、我々はデータ提供者に対して元の非集約形式のASV/OTUテーブルを提出することを強く推奨します。各ASV/OTUを個別のリード数と配列で保持することで、相互運用性を高め、不完全あるいは不正確な参照データベースによる誤った分類学的注釈に起因する有益なASV/OTUの喪失を防げます。
- 注: キュレーションを経て作成されたotuFinalの説明は、project metadataの
otu_final_descriptionに記載してください。
-
非キュレーション済み配列/分類群テーブル(taxaRaw)(任意)
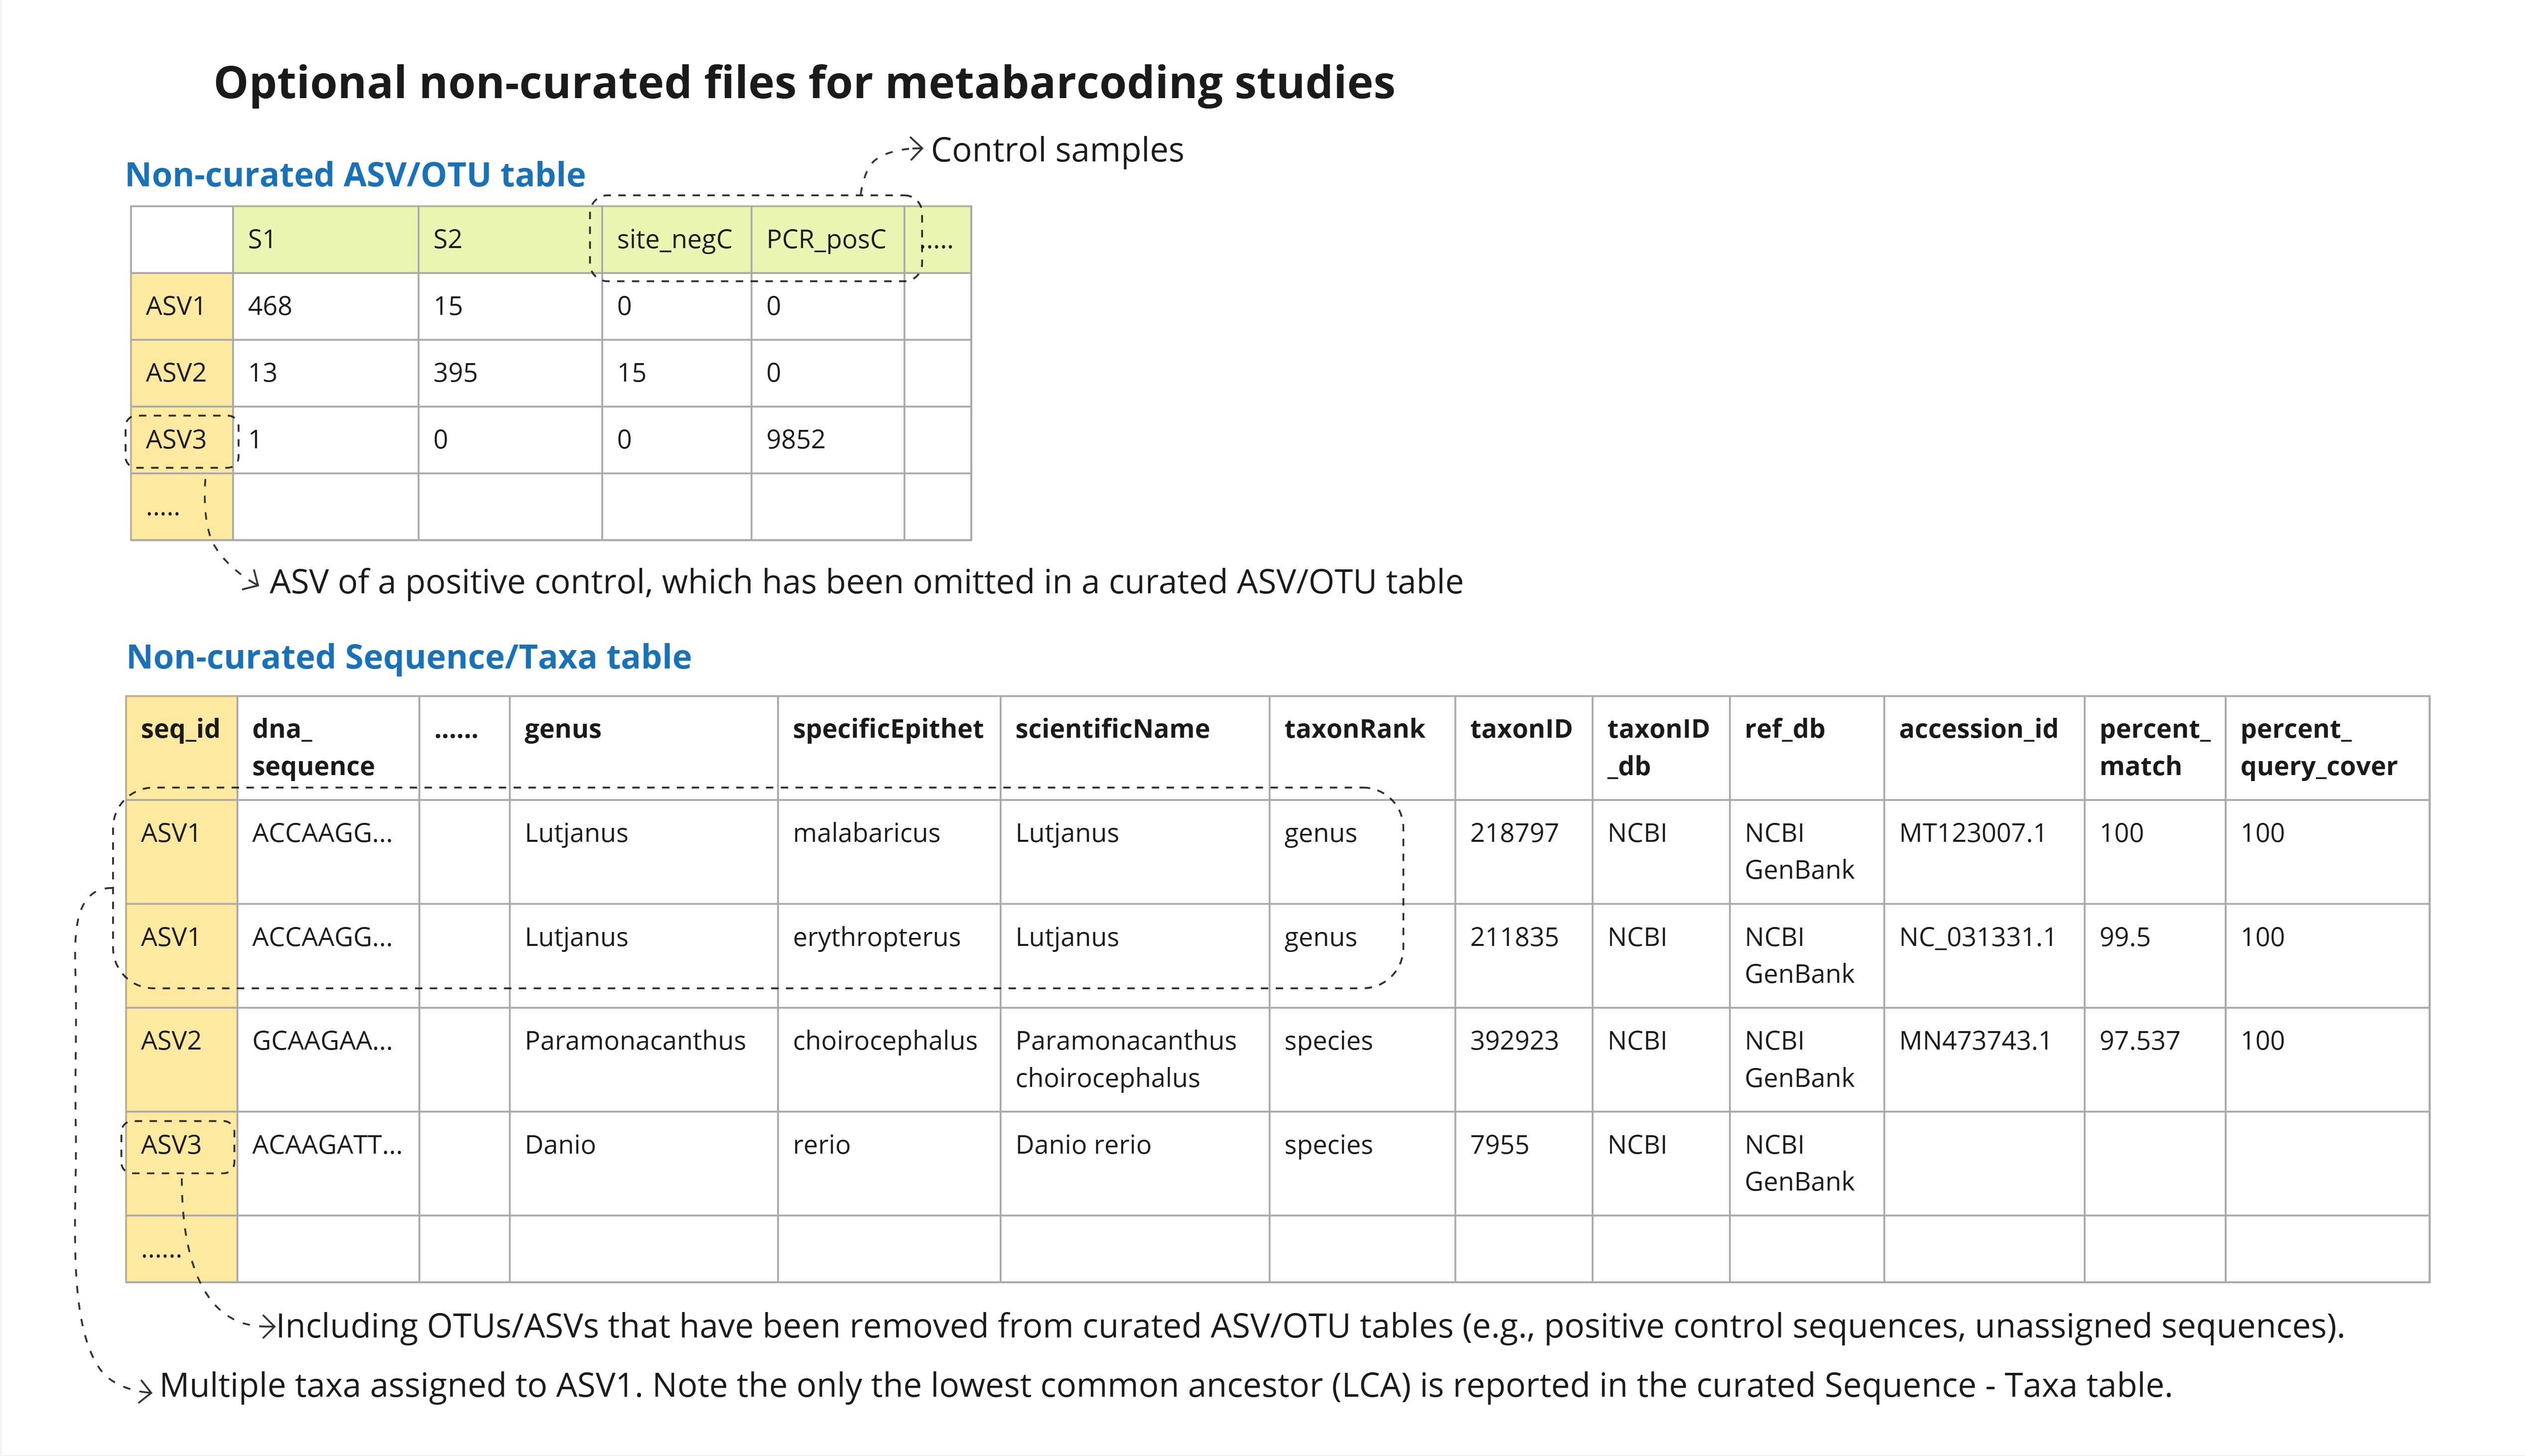
- 内容: キュレーション済みのSequence–Taxaテーブル(下記)に含まれる内容に加え、キュレーション済みASV/OTUテーブルから除外されたASV/OTU(例:非ターゲット分類群、汚染、ポジティブコントロール配列、分類学的ヒットがないASV)を含みます。また、単一のASV/OTUが複数の分類群に割り当てられている場合、それぞれの割り当て分類群について複数行を含めることがあります。
- 目的: キュレーションで除外されたASV、OTU、分類群へのアクセスを提供することでデータ透明性を高め、データ再利用者が特定のデータキュレーション手順を再評価・再実行できるようにすること。
- 注: 単一ASV/OTUに最小共通祖先(LCA)を割り当てる際は、割り当てられた各分類群の情報を記録するためにASV/OTUごとに複数行を生成してください。ユーザーは例えば97%の類似度閾値を適用し、この範囲に含まれるすべての参照配列、あるいはその代表サブサンプルを出力に含めることができます。
- 注: 図3の例(非キュレーション済みSequence/TaxaテーブルのASV1)を参照してください。
-
キュレーション済み配列/分類群テーブル(taxaFinal)
- 内容: キュレーション済みASV/OTUテーブルにリストされた各
seq_idのDNA配列。分類群が割り当てられている場合は、割り当てられた分類学的情報および割り当ての品質指標(例:一致率%、クエリ被覆率%)を含めます。単一ASV/OTUに複数の分類群が割り当てられる場合は、LCAを割り当て分類群として使用してください。 - 目的: データ再利用者が推定された分類学の特異性と正確性を評価し、異なるまたは更新された参照配列データベースを用いて分類学的再注釈を行えるようにすること。
- 注: 分類学的割り当てがないASV/OTUでも、研究の範囲に関連がある場合はtaxaFinalに含めますが、分類学情報(例:
scientificName)は空にしてください。
- 内容: キュレーション済みASV/OTUテーブルにリストされた各
一貫した識別子とファイル命名
機械可読性とデジタルリソースへの永続的な参照を確保するために、データセット全体で一貫した永続的なサンプルおよび配列識別子(samp_name、lib_id、seq_run_id)を適用することが重要です(Damerow et al., 2021; McMurry et al., 2017)。同様に、各ファイルはproject_id、assay_name、seq_run_idで構成される明確かつ一意な名前を持つ必要があります(表2およびサンプルデータ参照)。例えば、キュレーション済みASV/OTUテーブルは otuFinal_project_idassay_nameseq_run_id(例:otuFinal_gbr2022_MiFish_lib20230922.csv)と命名します。複数のデータコンポーネントを単一のスプレッドシートワークブックに格納する場合、ファイル名は project_id(例:gbr2022.xlsx)とし、この場合各ワークシート名は表2の形式に従うが、メインファイル名に既にproject_idが含まれるためワークシート名には project_id を含めない(例:otuFinal_MiFish_lib20230922)。
Table 1. 各データタイプの標準化された名称。例では project_id = gbr2022、samp_name = S1、assay_name = eSERUS および MiFish(ターゲット法およびメタバーコーディング法)、seq_run_id = run20230922
| Data type | Name format | Example |
|---|---|---|
| Project metadata | projectMetadata_project_id |
projectMetadata_gbr2022.csv |
| Sample metadata | sampleMetadata_project_id |
sampleMetadata_gbr2022.csv |
| PCR standard data | stdData_project_id |
stdData_gbr2022.csv |
| eLow Quant data | eLowQuantData_project_id |
eLowQuantData_gbr2022.csv |
| Amplification data | ampData_project_id_assay_name |
ampData_gbr2022_eSERUS.csv |
| Experiment/run metadata | experimentRunMetadata_project_id |
experimentRunMetadata_gbr2022.csv |
| Non-curated ASV/OTU table | otuRaw_project_id_assay_name_seq_run_id |
otuRaw_gbr2022_MiFish_run20230922.csv |
| Curated ASV/OTU table | otuFinal_project_id_assay_name_seq_run_id |
otuFinal_gbr2022_MiFish_run20230922.csv |
| Non-curated Sequence/Taxa table | taxaRaw_project_id_assay_name_seq_run_id |
taxaRaw_gbr2022_MiFish_run20230922.csv |
| Curated Sequence/Taxa table | taxaFinal_project_id_assay_name_seq_run_id |
taxaFinal_gbr2022_MiFish_run20230922.csv |
FAIReメタデータチェックリスト
我々はFAIR eDNA(FAIRe)メタデータチェックリストを作成し、異なるデータコンポーネントと方法論を記述するための包括的な語彙を提供しています。チェックリストの最新版、完全テンプレート、および変更履歴付きの過去バージョンは Downloadタブ から入手できます。詳細なドキュメンテーションは、研究の透明性と再現性を向上させ、特定の再利用ケースに対するデータ適合性の評価を可能にするために重要です。FAIReチェックリストは合計337のデータ項目(必須38、強く推奨51、推奨128、任意120)で構成され、ワークフローセクション(例:サンプル採取、PCR、バイオインフォマティクス)に整理されています。多くの必須・強く推奨・推奨項目はプロジェクトの通常の進行中に自然に生成されるため、最低報告要件を満たすデータは容易に用意・公開リポジトリへ提出できます。
語彙の基礎
FAIReメタデータチェックリストは、MIxS、DwC、およびDwCへのDNA由来データ拡張など既存のデータ標準から用語を取り入れて構成されています。MIxSには、eDNAデータに関連する複数のチェックリストや拡張(MIMARKS、MIMS、環境別拡張:水、堆積物、土壌、空気、ホスト関連、共生体関連など)が含まれます。これらの標準はeDNAデータの包括的なカバーを確保するためにレビューされ、FAIReチェックリストに取り込まれています。さらに、MIQEガイドライン(Bustin et al., 2009)、単一種eDNAアッセイ開発と検証のチェックリスト(Thalinger et al., 2021)、およびMIEM(Minimum Information for eDNA and eRNA Metabarcoding)ガイドライン(Klymus et al., 2024)からの用語も取り入れています。既存標準からの各用語の出典とURIは、FAIReチェックリストの「source」および「URI」列に記載されています。必要に応じて、eDNAコミュニティによる解釈を容易にするために、用語名、説明、例を修正しています。eDNA手順とデータセットの多様な属性に対応し再利用適合性の評価を改善するために、合計158の新しい用語を提案しました。これらには、標的アッセイ検出ワークフローに関連する用語(例:lod_method、std_seq)、バイオインフォマティクスツールやフィルタリングパラメータ・カットオフ(例:demux_tool、demux_max_mismatch)、分類学的割当指標(例:percent_match)、および分類群スクリーニング手法(例:screen_contam_method、screen_nontarget_method)が含まれます。FAIReチェックリストは、MIxSサンプル拡張(Water、Soil、Sediment、Air、HostAssociated、MicrobialMatBiofilm、SymbiontAssociated)から抽出した、eDNAサンプルに関連する多様な環境変数も含みます。これらの変数は通常サンプリングイベント中に記録され、共有することで高度なモデリング手法などに役立ちます。
FAIReチェックリストに適切な用語名がない場合、利用者は MIxS や DwC といった既存標準で検索し、可能な限り標準化用語を使用してください。該当する用語が見つからない場合は、関連する表内で明確かつ簡潔な記述的名称を用いて新しい用語を追加できます。
用語の指定使用と制御語彙
用語の標準化を高めるためにいくつかのアプローチを実装しています。第一に、既存標準の自由記述式の用語については制御語彙の使用を提案しています。例えば、target_geneの値はバーコーディングに用いられる28の遺伝子領域のリストから選択するようにします。これにより、COIの表記揺れ(CO1、COXI、COX1、Cytochrome oxidase I gene、Cytochrome c oxidase I など)や綴り誤りの入力を防ぎます。適切な値が語彙の指定値に見つからない場合は、“other:”に続けて自由記述で説明を入れることが可能です。第二に、数値変数の単位は可能な限り国際単位系(SI)に基づいて厳格に指定し、単位を含まない数値エントリのみを許可します。単位が明確な伝達に必要な場合は、測定値と測定単位の別々の用語を提供し、単位は制御語彙で制限します(例:数値は samp_size、単位は samp_size_unit で mL、L、mg、g、kg、cm2、m2、cm3、m3、other のような選択肢に限定)。第三に、いくつかのデータ用語のフォーマットは制限され、一般的に他の標準(DwC、MIxS)やデータインフラ(GBIF、OBIS、INSDC)に従います。例えば、decimalLatitude と decimalLongitude は必須用語であり、WGS84測地系の十進度(decimal degrees)でなければなりません。元のデータが他の形式(度分秒、UTM、WGS84以外の測地系)で記録されている場合は、verbatimLatitude と verbatimLongitude に格納しつつ、decimalLatitude と decimalLongitude も入力する必要があります。同様に、採取日時は eventDate に要約され、ISO 8601形式 を利用し、UTCとの差を付記します(例:"2008-01-23T19:23-06:00" はUTCより6時間遅いタイムゾーンを示す)。変換前の元の日時記録は verbatimDate および verbatimTime に保管してください。
欠損値
情報が欠落する理由は様々で、歴史的に科学では欠損データを示すために多様な慣習が用いられてきました。さらに、座標情報は絶滅危惧種や先住民および地域コミュニティの文化的に重要なサイトを保護するために一般化または非公開にされる場合があります(Chapman, 2020; Chapman and Wieczorek, 2020; Frank et al., 2015, https://fnigc.ca/)。データを非公開または一般化した理由は、project metadata の informationWithheld および dataGeneralization の用語で説明してください。必須項目に値が欠落している場合は、INSDC missing value controlled vocabulary の形式に従って理由を記載する必要があります。非必須項目に対してもこのアプローチを適用することを推奨します。
以下に、欠損値用語の完全なリスト(明確性のために階層構造を含む)を示します。説明文や追加理由は含めず、太字で示されたテキストのみを欠損値記述に使用してください。
- not applicable: control sample
- not applicable: sample group
- not applicable
- missing: not collected: synthetic construct
- missing: not collected: lab stock
- missing: not collected: third party data
- missing: not collected
- missing: not provided: data agreement established pre-2023
- missing: not provided
- missing: restricted access: endangered species
- missing: restricted access: human-identifiable
- missing: restricted access
データ提出/公開
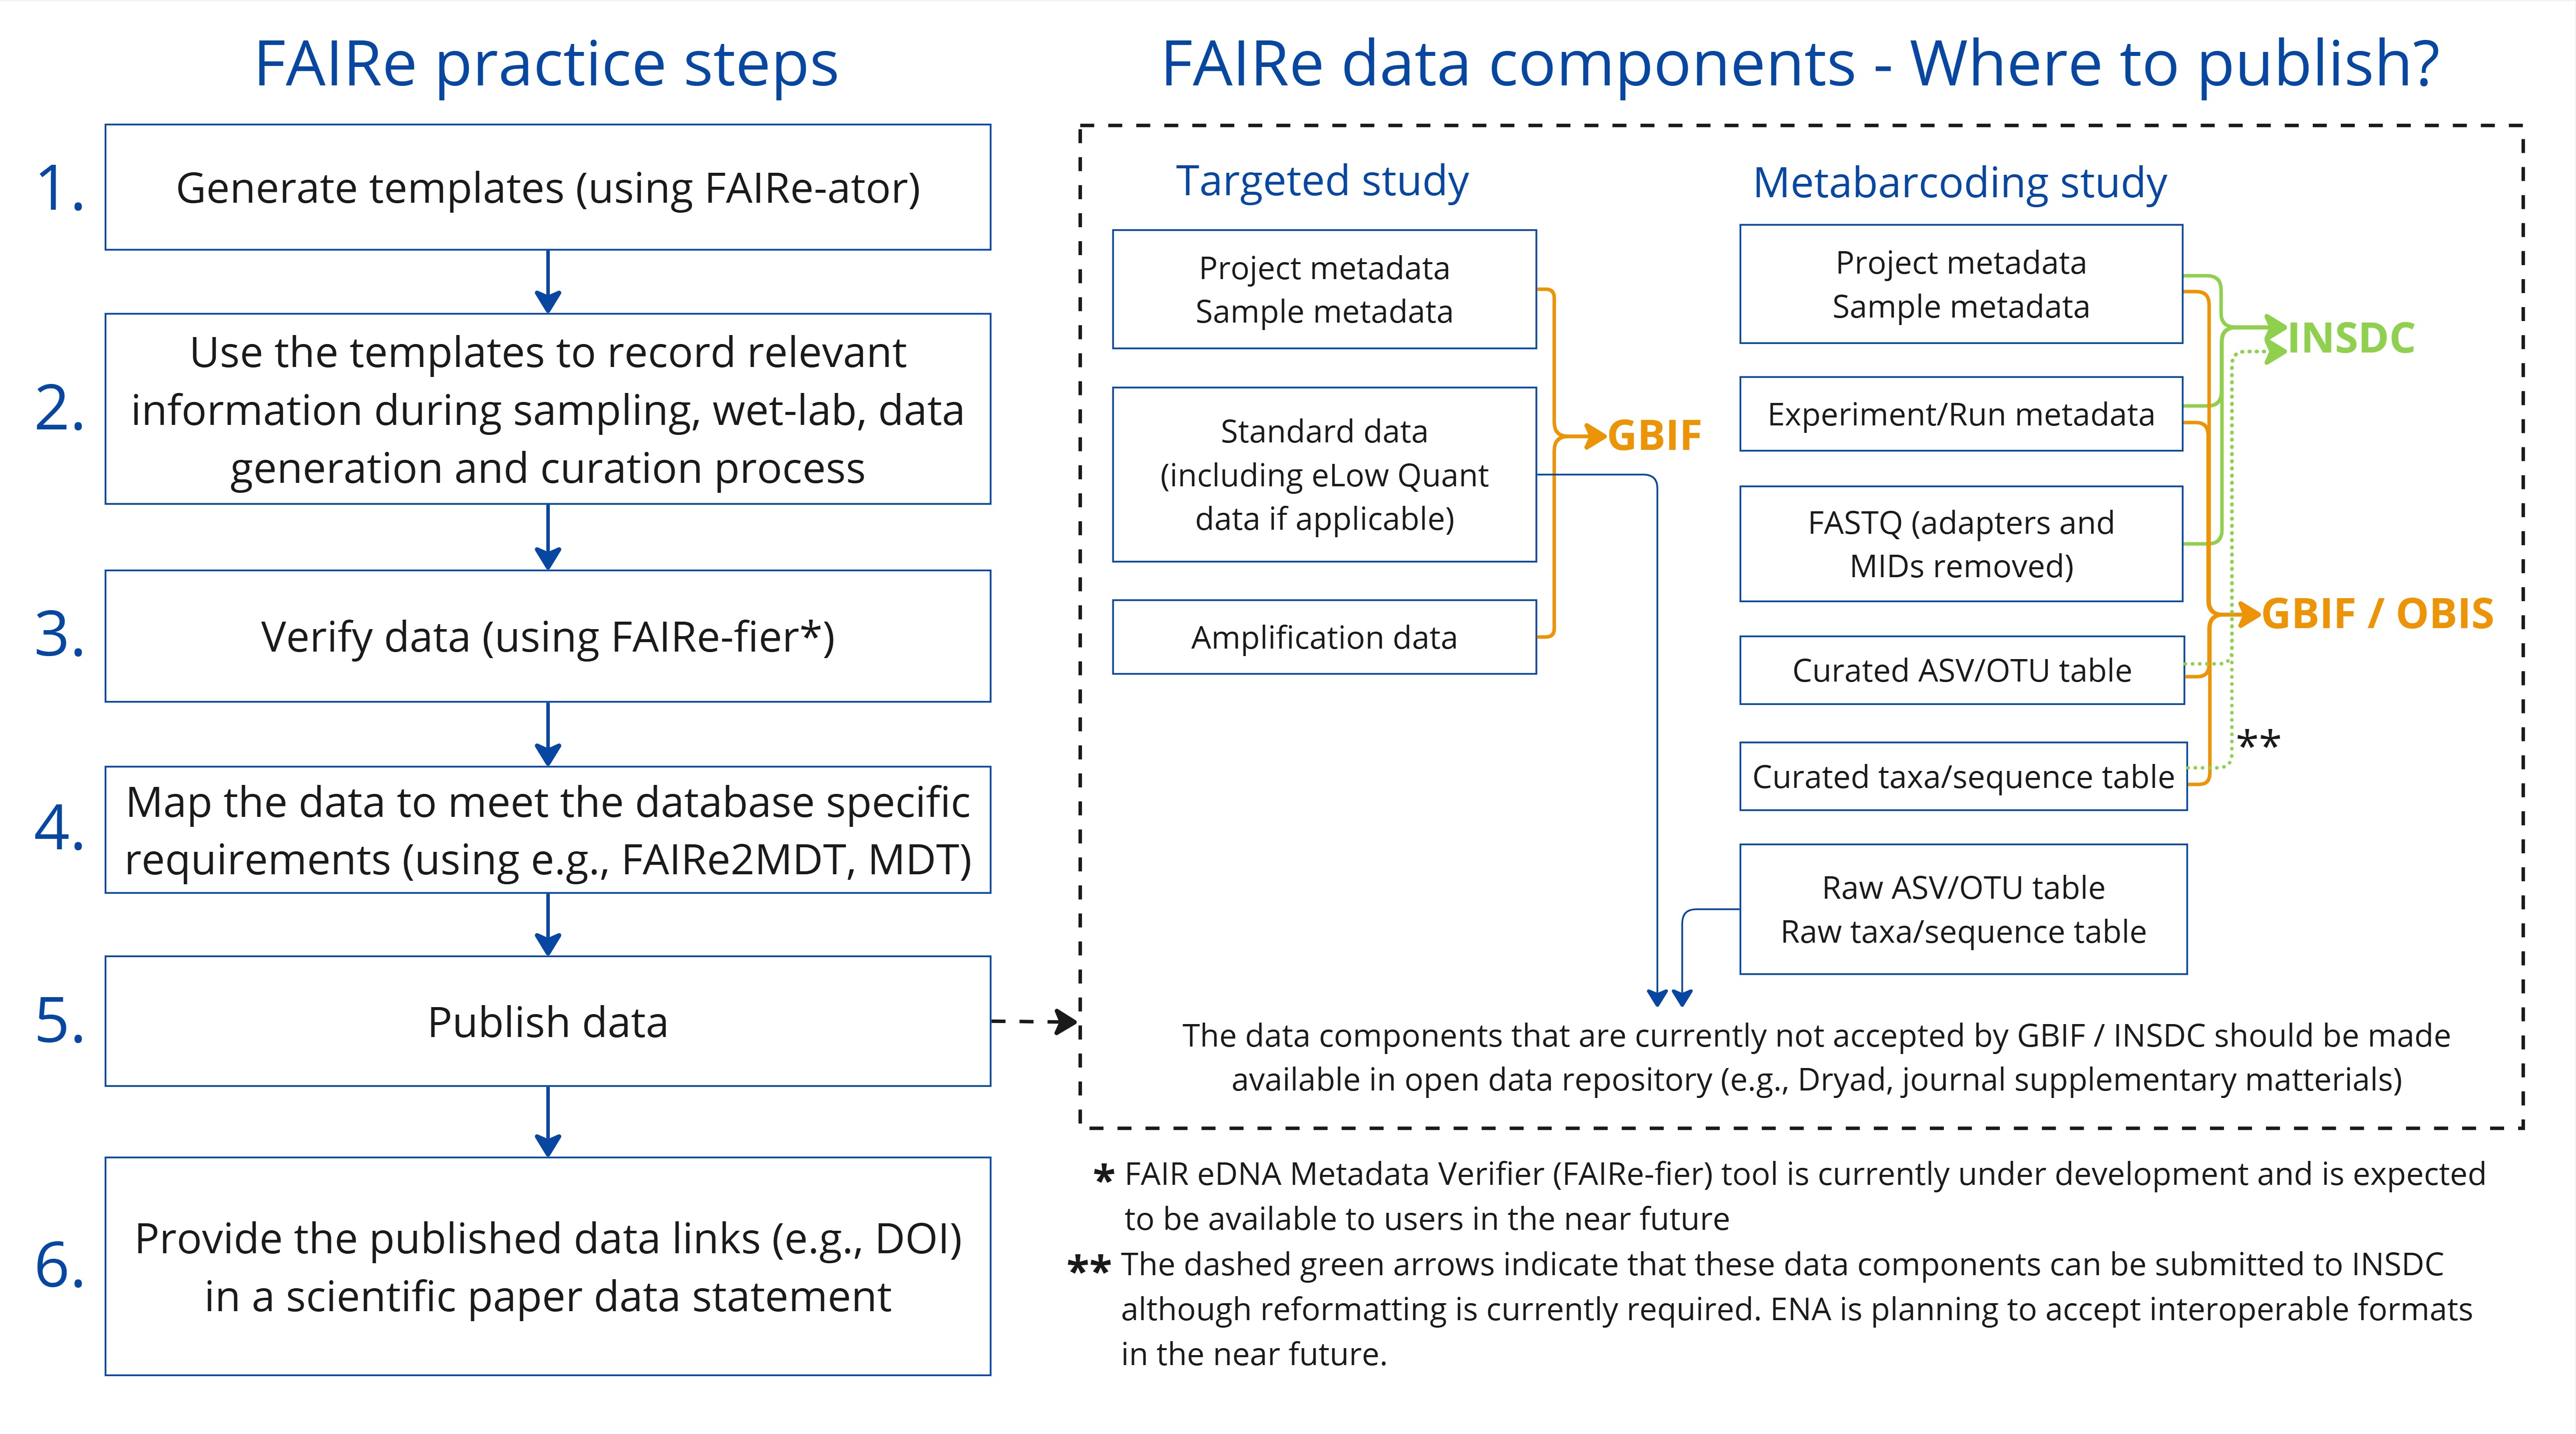
eDNAデータセットを GBIF、OBIS、INSDC のようなデータベースに公開することは、FAIRデータ実践を確実にするための重要なステップです。これらのプラットフォームは、オープンデータに基づく科学研究や意思決定のためのデータ検索性とアクセス性を提供し、APIや高度なウェブブラウザインターフェースを通じて利用可能にします。提出時にデータ検証手順を提供し、相互運用性を確保する追加の標準化を行います。これらのデータベースへの提出により永続的なサンプルおよび配列識別子が提供され、機械可読性とデータへの長期参照に不可欠です。例えばGBIFでは、データセットの著者や公開者に対し、引用追跡や利用状況の自動報告を可能にする一意のデータセットDOIが付与されます。 すべてのeDNAデータコンポーネントが単一のデータベースで十分に扱えるわけではないため、適切なデータベースに分割して提出することを推奨します(図2参照)。 以下は、主要なデータベース/インフラを通じてFAIR eDNAデータを共有する際の現行推奨実践です:
- 生のDNAシーケンスデータとメタデータは INSDC(例:ENA、NCBI、DDBJ)などのヌクレオチドデータベースに提出します(ENA: https://www.ebi.ac.uk/ena/browser/home、NCBI: https://www.ncbi.nlm.nih.gov/、DDBJ: https://www.ddbj.nig.ac.jp/index-e.html)。例えばNCBIでは、プロジェクトメタデータをBioProject、サンプルメタデータをBioSample、生シーケンスをSequence Read Archive(SRA)経由で提出できます(Barrett et al., 2012)。これにより、メタデータとシーケンスデータがリンクされ、BioProjectやBioSampleレコードを検索することで完全なデータセットを取得できます。
- 推定された分類群出現(配列とメタデータを伴う派生生物多様性データ)を GBIF や(海洋データの場合は)GBIFと OBIS に公開します。GBIFおよびOBISは、Abarenkov et al. (2023) 共著ガイドで説明されているDNA由来データ拡張を含むDwC標準に従ったフォーマットを前提としています。データセットはDarwin Core Archive(DwC-A)に変換され、GBIFおよびOBISでインデックス化されます。
- 残りのデータコンポーネント(例:ターゲットアッセイ研究の標準データ、メタバーコーディング研究の生ASV/OTUテーブル)をFAIReガイドラインに従って整形し、Dryad、Zenodo、Figshare などのオープンデータリポジトリや論文の補足資料としてアーカイブします。これにより上記ステップで扱われない生データの包括的な保管が保証されます。ただし、これらのリポジトリ内のデータは、eDNA、生物多様性、またはヌクレオチドデータの大規模プラットフォーム内での効果的な検索性や相互運用性を得るためのインデックス化が十分でない場合があることを認識することが重要です。
- プロトコルの公開およびバイオインフォマティクスや解析コードの共有も強く推奨されます(Jenkins et al., 2023; Teytelman et al., 2016)。protocols.io や WorkflowHub のようなオープンソースプラットフォームでの公開が推奨されます。
- 上記すべてのデータ、プロトコル、コードにはDOIを割り当て、それらをジャーナル記事内のデータアクセシビリティステートメントおよび
seq_archive、code_repo、associated_resourceのようなメタデータ項目に記載してください。
ここで示したガイドラインにより、ヌクレオチドおよび生物多様性データベースが受け入れる形式と若干異なるフォーマットでデータを整形することがあります。そのため、軽微な再フォーマットが必要です。例えば、1つのプロジェクトで複数のアッセイが適用された場合の必要なデータ形式が該当します。GBIFは最近、Metabarcoding Data Toolkit (MDT) を立ち上げ、ここで提案した形式に類似した表形式のメタバーコーディングデータを再整形してGBIFおよびOBISに公開するユーザーフレンドリーなウェブアプリケーションを提供しています(Abarenkov et al. (2023) のガイドラインに準拠)。GBIF MDTは現在、各アッセイごとに別個の入力データセットを要求します(したがってprojectおよびsampleメタデータの情報が繰り返されます)が、FAIReチェックリストは複数アッセイのメタデータを組み合わせることを許容します(図5)。FAIReデータテンプレートをMDT向けに変換するRスクリプト(FAIRe2MDT)が開発されており、FAIReとGBIF基準間のデータ形式の違いを橋渡しします(下記「Available scripts and tools」参照)。これらのツールを組み合わせることで、eDNAデータのGBIF/OBISへの公開が効率化されます。全体として、生物多様性データプラットフォームはeDNAベースデータの受け入れと deposit の適合性を向上させるために強力な取り組みを進めています。
利用可能なスクリプトとツール
以下のスクリプトとツールは、ガイドラインに従ったデータ整形を支援するために開発され、FAIRe GitHubリポジトリ にて公開されています。
- FAIRe-ator(FAIR eDNAテンプレート生成器): このR関数は、アッセイタイプ(ターゲットまたはメタバーコーディング)、サンプルタイプ(例:水、堆積物)、適用するアッセイ数などのユーザー指定パラメータに基づいてデータテンプレートを作成します。さらに、プロジェクトIDやアッセイ名を入力することで正しいファイル名フォーマットを保証し、テンプレート内の
project_idおよびassay_name項目を事前入力できます。READMEおよびRコードはこちら。 - FAIRe-fier(FAIR eDNAメタデータ検証器): このツールは ウェブインターフェース で利用可能です。ソースコードは GitHub にあり、追加のメタデータと引用情報は http://hdl.handle.net/102.100.100/706519?index=1 にあります。スクリプト不要でメタデータを検証でき、プロジェクトおよびサンプルメタデータを入力後にツールへアップロードして検証を行えます。ツールは必須用語が完了しているか、未完了の場合はproject metadata内の
information_withheldに有効な理由が提供されているかなどをチェックします。また、制御語彙のエントリやeventDate(ISO 8601形式)などの固定フォーマット用語が正しくフォーマットされているかも検証します。問題が見つかった場合は、警告とエラーメッセージを含む出力が提供され、修正箇所を示します。警告メッセージがない場合は整形済み出力が生成されます。 - FAIRe2MDT: FAIRe形式のeDNAデータテンプレートをGBIFの MDT 向けに変換するRスクリプトです。Rコードはこちら からダウンロードできます。
コミュニティによって開発されたツール FAIRe実装者によって開発されたスクリプトやツールが増えていることを紹介できるのは喜ばしいことです。FAIReガイドラインを採用し、自動化ツールを構築するグループが増えています。現在、これらのツールはRおよびPythonの両方で新しいパッケージとして開発中です — News & Updatesページの FAIRe Coding で最新情報を確認してください。
コミュニティでFAIRe関連ツールを開発している場合は、ぜひ contact us からご連絡ください — 連携や協力の機会を探したいです!
- FAIReSheets(Google Sheets向けFAIReテンプレート生成器): このPythonスクリプトはGoogle Sheets上にFAIRe eDNAデータテンプレートを作成します。FAIRe-atorのテンプレート作成を再現しますが、出力がMicrosoft ExcelファイルではなくGoogle Sheetsとなります。NOAA AOML 'OmicsのBayden Willms(ORCID / GitHub)によって開発されました(https://github.com/aomlomics)。
- FAIRe2ENA: FAIReフォーマットのメタデータをENA(European Nucleotide Archive)XML形式に変換するツール。Philipp Bayer(ORCID / GitHub)によって Minderoo Foundation OceanOmics で開発されました。
- Amplicon Nextflow: 品質管理、デノイジング、ASV/ZOTU生成、分類学的割当を行うバイオインフォマティクスパイプラインで、FAIReメタデータを入力および出力オプションとして使用できます。Adam Bennett(ORCID / GitHub)、Philipp Bayer(ORCID / GitHub)、Sebastian Rauschert(ORCID / GitHub)によって Minderoo Foundation OceanOmics で開発されました。
サンプルデータセット
さまざまなサンプルデータセットを用意しており、eDNA実務者がデータの整形と公開方法の参考にできます。
以下はFAIReチェックリストv1.0に従って整形された、ターゲットアッセイを用いるサンプルデータセットの一覧です。これらのデータセットは こちら で入手できます。
| recordedBy | Mark Louie Lopez | Neha Acharya-Patel | Cecilia Villacorta-Rath | Lynsey Harper |
|---|---|---|---|---|
| project_id | AEP_Fish_sedDNA | Rockfish_targeted_qPCR | EirwiniBurdekin | NECR534_GCN_single-species |
| bibliographicCitation | DOI | DOI | DOI | Link |
| assay_type | targeted | targeted | targeted | targeted |
| assay_name | eFish1 | eESLU1 | eCOAR7 | eSEMA3 | eSEPA9 | eSERU5 | EirwiniND4 | TCCB |
| env_medium | lake sediment [ENVO:00000546] | sea water [ENVO:00002149] | river water [ENVO:01000599] | liquid water [ENVO:00002006] |
| Output file 1 | AEP_Fish_sedDNA.xlsx | Rockfish_targeted_qPCR.xlsx | EirwiniBurdekin.xlsx | NECR534_GCN_single-species.XLSX |
| Excel worksheet 1 | projectMetadata | projectMetadata | projectMetadata | projectMetadata |
| Excel worksheet 2 | sampleMetadata | sampleMetadata | sampleMetadata | sampleMetadata |
| Excel worksheet 3 | stdData | stdData | ampData | stdData |
| Excel worksheet 4 | eLowQuantData | eLowQuantData | ampData | |
| Excel worksheet 5 | ampData_eFish1 | ampData_eSERU5 | ||
| Excel worksheet 6 | ampData_eESLU1 | ampData_eSEPA9 | ||
| Excel worksheet 7 | ampData_eCOAR7 | ampData_eSEMA3 |
以下はFAIReチェックリストv1.0に従って整形された、メタバーコーディングアッセイを用いるサンプルデータセットの一覧です。これらは こちら で入手できます。
(メタバーコーディングの表は原文のままの表構成を維持しています。)
よくある質問
Q. BLASTヒットがないASVはどうすべきですか?
A. 分類学的ヒットがないASVも将来の再注釈(参照データベースが改善した場合)に有用です。これらは otuRaw と taxaRaw テーブルに分類学フィールド(例:scientificName)なしで含めてください。もしこれらのASVが研究の範囲内で生態学的解析に関連する場合は、otuFinal と taxaFinal にも保持してください。
Q. FAIRe-fierはすべてのデータコンポーネントを検証できますか? A. いいえ。現時点でFAIRe-fierはメタバーコーディングおよびターゲットアッセイ研究の projectMetadata と sampleMetadata を検証しますが、他のコンポーネント(例:experimentRunMetadata、ampData)はまだ検証対象に含まれていません。これらの追加コンポーネントのサポートは将来のバージョンで計画されています。
参考リソース
現在のFAIReフレームワークは以下のリソースを基礎として開発されました。
- Darwin Core Quick Reference Guide
- Minimum Information about any (x) Sequence (MIxS) standard
- Darwin Core extension of DNA derived data
- Abarenkov et al., (2023) Publishing DNA-derived data through biodiversity data platforms, v1.3. Copenhagen: GBIF Secretariat.
- The OBIS manual
- GBIF Metabarcoding Data Toolkit